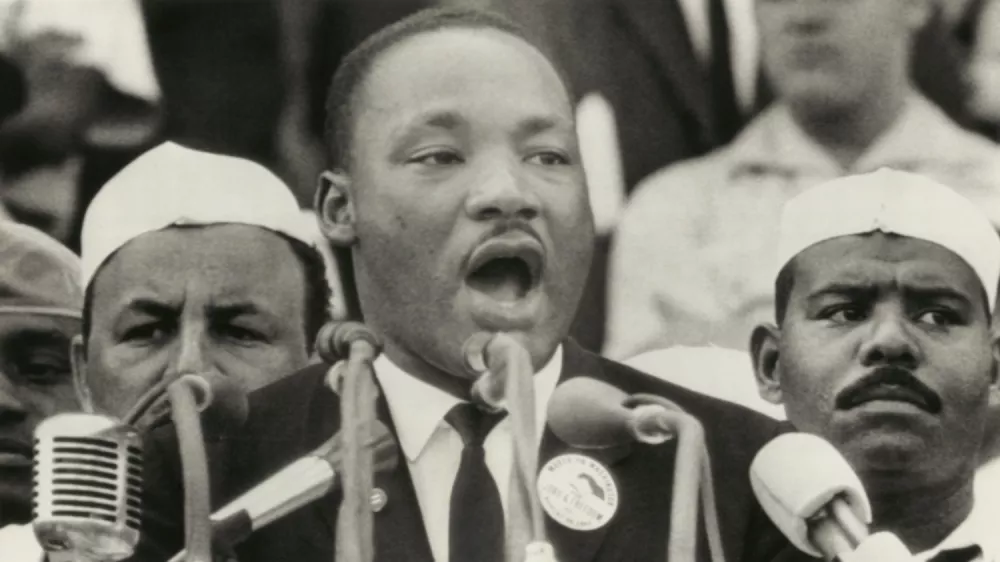


Programska oprema za zaznavanje strojno ustvarjenih besedil je kultni govor Martina Luthra Kinga mlajšega, Imam sanje (»I have a dream«), iz leta 1963 označila za delo umetnega algoritma. Odkritje je del obsežne raziskave, ki je razgalila nezanesljivost detektorjev umetne inteligence. Na ta orodja pa se danes množično zanašajo izobraževalne ustanove in založniška industrija.
Raziskava ameriške univerze Kennesaw State, nedavno objavljena v strokovni reviji Information, pritrjuje bojaznim tehničnih strokovnjakov, ki sumijo, da programi pogosto neupravičeno kaznujejo visoko strukturirano in jezikovno bogato človeško pisanje.
Ugotovitve so objavili v ključnem času. Na podlagi tovrstnih orodij so denimo znanega pisatelja Thelysona Oreliena javno obtožili, da je njegov nagrajeni roman plod strojnega učenja.
V preizkusu šestih priljubljenih detektorjev so znanstveniki analizirali uradni prepis Kingovega zgodovinskega govora iz ameriškega nacionalnega arhiva. Rezultati so opozorili na popolno zmešnjavo. Orodje ZeroGPT.com je ocenilo, da je 87,7 odstotka besedila napisala umetna inteligenca, ZeroGPT.net pa je pokazal 84,4-odstotno verjetnost strojnega izvora. Preostala štiri spletna orodja so govor pravilno prepoznala kot človeško delo.
Zgodovinski govori pa niso edina žrtev takšnih tehnoloških pomanjkljivosti. V analizi 35 različnih besedil so detektorji elitnih univerz, kot sta MIT in Harvard, pogosto ocenili za stoodstotno strojno generirane. Pet od šestih programov je kot algoritemsko delo napačno označilo celo prelomni znanstveni članek o globokem učenju avtorjev Yanna LeCuna in Yoshue Bengia. Besedilo pa je bilo napisano davno pred obstojem sodobnih modelov umetne inteligence.
Natančnost analiziranih detektorjev se je gibala med poraznimi 14,3 in 71,4 odstotka, je opozoril vodja raziskave Tadesse Wakjira. Algoritmi namreč ne ločijo med skrbno izpiljenim akademskim slogom in zglajenim strojno generiranim besedilom.
»Nobeno od teh orodij ne ponuja stopnje zanesljivosti, potrebne za kritične odločitve,« se glasi končna ocena avtorjev študije. Odsvetujejo njihovo slepo uporabo pri disciplinskih postopkih proti študentom ali v selekcijskih postopkih pri zaposlovanju, saj so posledice lažnih obtožb prehude.
Kljub vsemu pa razvijalci takšnih orodij nadaljujejo z delom. Novejša generacija programov, izurjena na precej širših podatkovnih bazah, že kaže boljše rezultate. Julija je inštitut Epoch AI testiral naprednejše sisteme, kot sta Pangram in posodobljeni GPTZero. Na vzorcu 495 človeških besedil ta orodja niso zabeležila niti ene same napačne ocene strojnega izvora, orodje Originality.ai pa se je zmotilo samo v treh odstotkih. Toda ko je umetna inteligenca namenoma oponašala slog določenega človeškega avtorja, se je detektorjem izmuznila več kot desetina besedil.